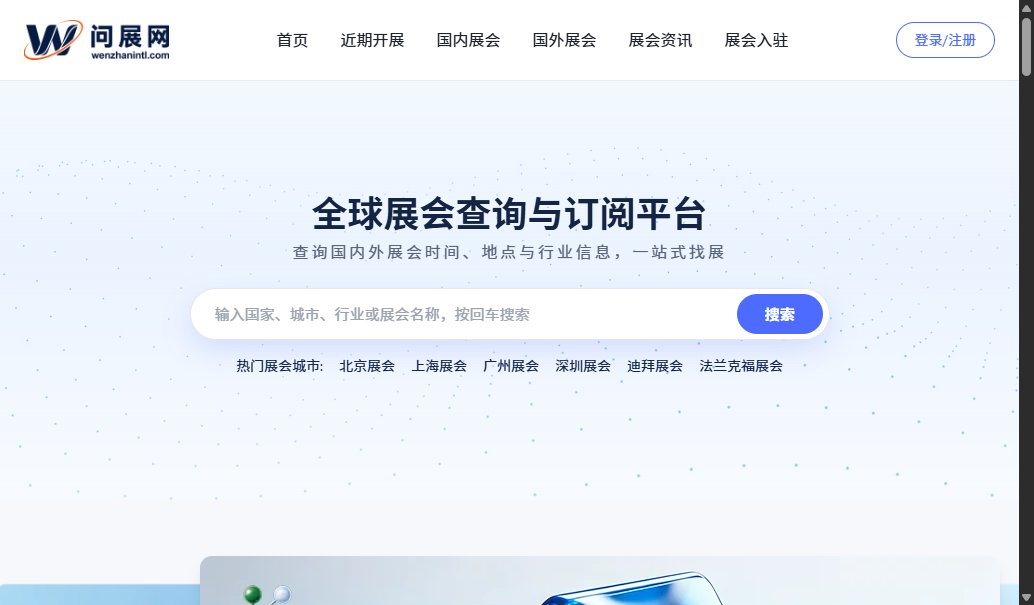
问展网首页(www.wenzhanintl.com),按国内/国际、行业、城市组织展会数据
项目概况
| 客户 | 问展网(Wenzhan) |
|---|---|
| 站点 | www.wenzhanintl.com |
| 所属行业 | 会展信息服务 / 跨境贸易 |
| 业务形态 | 全球展会查询、展位与门票预定、展会入驻、展会资讯、品牌招商 |
| 服务范围 | GEO 诊断与技术整改、抓取策略、结构化数据、AI 可读内容建设 |
| 实施方 | 深圳市奇点大数据科技有限公司 |
| 记录时间 | 2026-10-17(现场实测) |
为什么展会平台特别需要 GEO
展会信息有三个绕不开的特征:
- 强时效:开展日期一过,页面价值迅速衰减,爬虫必须知道「哪一页是新的」。
- 强长尾:城市 × 行业 × 月份 × 国家 可以组合出几十万条查询,靠人工写落地页不可能覆盖。
- 强决策:问「什么时候、在哪、怎么参展」的人,本身就是要掏钱展位费的参展商或采购商。
这三条决定了:谁能把「展会名称 + 起止时间 + 展馆 + 城市/国家 + 行业 + 主办方」变成机器可以直接抽取的字段,谁就更容易成为 AI 回答里的那个信源。只做人能看懂的列表页,等于把答案让给同行。
我们做了什么
1. 抓取层:把入口交还给爬虫
- sitemap 索引拆分:按内容类型拆成 5 个子图(静态页、展会、文章、展馆、AI 入口),新增展会只更新对应子图,不必整站重提。
- robots.txt 按爬虫分组:Googlebot、Bingbot、百度、搜狗、360 与 GPTBot、ClaudeBot、PerplexityBot 等 AI 爬虫分别声明;同时屏蔽登录、订阅、验证码等无索引价值路径,以及 .env、.git、密钥文件等敏感路径。
- canonical 统一:同一批展会会因筛选参数、排序参数产生多个 URL,用 canonical 指向规范地址,避免重复内容消耗抓取预算。
2. 语义层:给 AI 一份站点说明书
上线 llms.txt,用一段话讲清「问展网是什么、覆盖哪些栏目、提供哪些服务」,并列出首页、国内展会、国际展会、近期展会、展会资讯、展会入驻、品牌招商、联系我们 8 个入口。模型不需要猜站点结构,直接读。
3. 结构层:让展会成为「实体」,而不是「列表项」
首页与核心栏目输出 JSON-LD,明确组织与站点实体关系;展会详情按 Event 模型组织名称、起止时间、展馆、城市、国家、行业、主办方等字段,与页面上的订阅数、开展倒计时形成互相印证的数据块——这类「可核对的事实」正是 AI 最愿意引用的部分。
说明:Event 字段按展会类型分批覆盖,属于第二阶段持续补齐项,不在本次一次性交付范围内。
4. 内容层:把行业术语翻译成用户问题
展会资讯不只发新闻稿,而是回答「第一次参展要准备什么」「海外展会签证与物流怎么安排」「展位一般提前多久订」这类真实决策问题。这些问题与 AI 的提问方式高度重合,比「热烈祝贺某某展会开幕」有用得多。
可验证的现场数据(2026-10-17 实测)
| 首页响应 | HTTP 200,HTML 285,548 字节 |
|---|---|
| 首页正文 | 7,467 字(去标签统计) |
| llms.txt | HTTP 200,888 字节 |
| robots.txt | HTTP 200,2,585 字节,更新于 2026-10-15 |
| sitemap.xml | HTTP 200,索引 5 个子图 |
| canonical | 首页已声明 |
| 结构化数据 | 首页 JSON-LD 1 组 |
| 内容覆盖 | 国内展会、国际展会、近期展会、16 个行业分类、品牌招商、展会资讯、展会入驻、出海服务 |
这些数字都可以自己打开看一眼。案例页只写能复核的东西,不写「提升了多少倍」。
怎么判断有没有效
不看「收录了多少页」,看三件事:
- 品牌提及率:固定 20 条问句(例如「2026 巴黎巧克力展什么时候」「深圳 11 月有哪些电子展」),在 Kimi、豆包、DeepSeek、腾讯元宝上提问,回答里是否出现「问展网」。
- 官网引用率:回答是否给出 wenzhanintl.com 的具体页面链接,而不是只提一个名字。
- 引用页面分布:被引用的是首页,还是某个展会详情页——后者才说明结构化字段真正生效。
AI 引擎重新抓取、理解并开始引用通常需要 4 至 12 周,且会随模型版本变化。任何承诺「一周上 AI 推荐位」的说法都不成立,我们也不做这种承诺。
这个案例的适用范围
凡是「数据库 + 强时效 + 长尾查询」的站点,方法可以直接复用:展会、招标、招聘、房源、活动票务、政策法规库、产品参数库。共同点是——你的内容本来就是结构化的,只是没有用机器读得懂的方式输出。